Модели Claude: как выбрать под задачу продакта
Как сравнить модели Claude на своих данных: один бриф, одинаковые критерии, проверка фактов и разумный уровень усилий.
Ты просишь Claude разобрать заметки интервью и получаешь длинный уверенный ответ. Это ещё не означает, что выбранная модель лучше другой: возможно, она просто подробнее пересказала те же данные. Для выбора нужен небольшой рабочий тест с заранее известными ошибками, которые нельзя допустить.
Ниже сравним два доступных варианта на продуктовом брифе. Цель — получить правило выбора для своей работы, а не универсальный рейтинг всех моделей Claude.
1. Раздели модель, усилия и доступ аккаунта
В справке Claude модель выбирается в меню рядом с кнопкой отправки. Там же находятся настройки усилий — Effort — и мышления, если они доступны для выбранного варианта. Изменение применяется к следующему ответу.
Доступный список зависит от аккаунта и настроек организации. Запиши полное название с версией, а не только «Sonnet». Более высокий Effort обычно требует больше времени и использования; он не даёт гарантии безошибочного ответа. Не меняй одновременно модель, промпт и настройки — иначе причина различия останется неизвестной.
2. Выбери двух кандидатов под конкретную работу
Claude Academy описывает семейства Haiku, Sonnet, Opus и Fable через разные требования к скорости и сложности работы. Эти ориентиры помогают выбрать кандидата, но не заменяют проверку на твоих материалах.
| Семейство | С какой задачи начать проверку |
|---|---|
| Haiku | Извлечение известных полей, короткая сводка |
| Sonnet | Рабочий текст, анализ и несколько связанных шагов |
| Opus | Сложные противоречия и глубокий разбор |
| Fable | Длительная задача с несколькими этапами и проверками |
Это ориентиры производителя, а не наши результаты замеров. Точную версию и доступность смотри в своём меню. Для упражнения выбери два доступных варианта; не нужно покупать доступ ко всем семействам ради сравнения.
3. Подготовь тест с известными ловушками
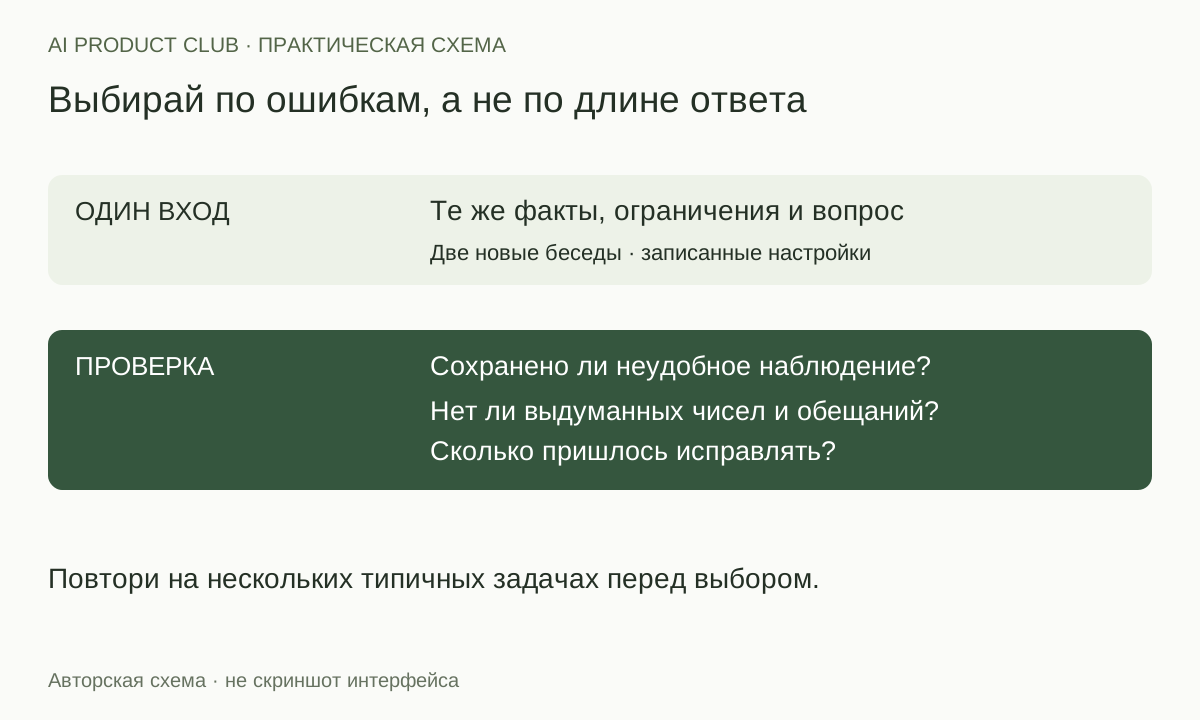
Скопируй учебный пакет в две новые беседы. Одинаковый вход помогает сравнить ответы без влияния предыдущей переписки.
Учебный бриф: фильтр новых строк в отчёте.
F-01: два участника попросили быстрее находить изменения.
F-02: один участник сказал, что текущий способ его устраивает.
F-03: команда предложила автоматическую отправку отчёта.
F-04: пользователи отправку не обсуждали.
Ограничение пилота: только просмотр, без отправки.
Неизвестно: частота проблемы и время ручной проверки.

Задача: выпиши наблюдения, гипотезы и неподтверждённые обещания.
Для каждого вывода укажи F-ID. Предложи 3 вопроса следующего интервью.
Не делай вывод о большинстве рынка по этим данным.
Ответ до 300 слов. Не добавляй внешние факты.
Заранее запиши ожидаемые свойства ответа: F-02 сохранён; предложение команды отделено от пользовательского запроса; время не выдумано; автоматическая отправка не попала в пилот. Это твой эталон проверки, а не заранее написанный «идеальный» литературный ответ.
4. Сравни ошибки, а не впечатление
Для каждой беседы заполни короткую карточку:
Модель и версия:
Effort, если доступен:
Пропущенные факты:
Неподтверждённые утверждения:
Нарушенные ограничения:
Что пришлось исправить вручную:
Время до пригодного результата:
Не ставь оценку только за подробность. Ответ с десятью разделами, который потерял F-02, хуже короткого ответа, сохранившего разные позиции. Источник у каждого вывода тоже нужно проверить: правильный ID рядом с неверным пересказом не делает вывод достоверным.
Повтори упражнение на другом пакете, где нет явной проблемы, и на пакете с противоречащими заметками. Одна удачная выдача может быть случайной. Для первого выбора достаточно нескольких характерных случаев; не выдавай такой набор за научный бенчмарк.
5. Меняй усилия после разбора конкретной ошибки
Если обе модели путаются, сначала посмотри на исходные данные. Возможно, в них не обозначено, что относится к пользователю, а что — к идее команды. Более сложная модель не восстановит отсутствующий факт.
Если вход ясен, но модель пропускает взаимосвязь, повтори тот же запрос с другим доступным уровнем Effort. Запиши изменение отдельно. Если результат стал длиннее, но ошибка осталась, повышение усилий не решило задачу.
Мой подход: выбирать стоит самый простой вариант, который устойчиво проходит важные проверки. Я бы повышал сложность модели ради конкретной нерешённой ошибки, а не ради ощущения, что задача «достаточно серьёзная».
6. Сохрани понятное правило выбора
Напиши правило для команды без вечных рейтингов: «извлечение полей начинаем с проверенного быстрого варианта; спорные выводы исследовательского отчёта передаём варианту, который лучше прошёл наш набор; перед решением человек проверяет основания».
Добавь дату, версии и три тестовых пакета. После заметного обновления модели повтори тот же набор. Если условия задачи изменились — например, вместо коротких заметок появился большой документ с таблицами — старый результат проверки уже не отвечает на новый вопрос.
Для контроля использования веди журнал по инструкции о лимитах Claude. Лимиты и качество связаны с выбором, но это разные критерии: экономный ответ, который приходится полностью переделывать, может не экономить рабочее время.
Проверка материала: официальные источники сверены 7 октября 2026 года. Сравнительный прогон моделей не проводился; таблица семейств отражает позиционирование производителя, тест и критерии — учебные.
Практику выбора ИИ под рабочие задачи разбираем на AI Product Fast Track.
Преврати ИИ-инструменты в рабочую систему
«Быстрый старт в AI»: практические воркшопы по AI-инструментам, прототипам и автоматизации. Собираем результат, который можно применить в работе.
21 практических воркшопов · записи · вопросы автору в чате
Посмотреть программу курса ↗