Ollama timeout: как найти причину обрыва ответа
Отдели таймаут клиента от загрузки модели и перегрузки Ollama: маленький тест, журналы и порядок диагностики.
Автоматизация ждёт ответ Ollama и сообщает timeout. Это ещё не доказывает, что модель сломалась: запрос мог прерваться в клиенте, долго ждать загрузки или стоять в очереди. Полезнее найти место задержки, чем сразу увеличивать все таймауты.
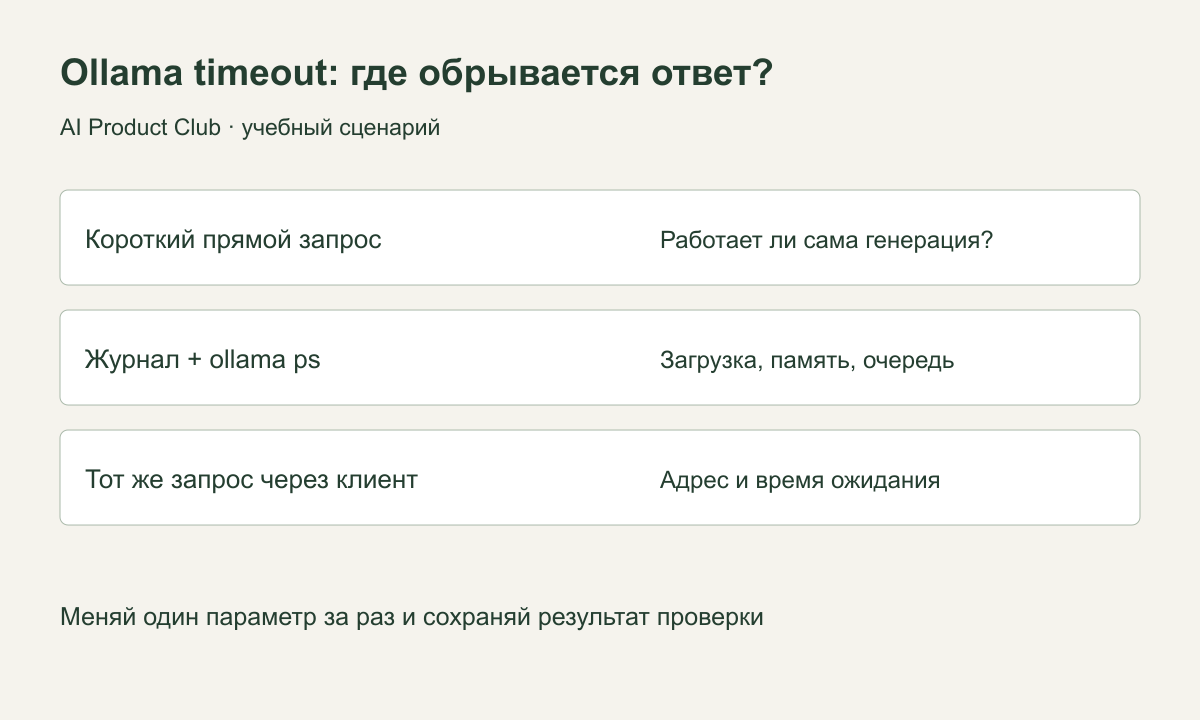
Ниже — диагностика локального пилота. Мы не меняем сетевые права и не открываем сервер наружу. Если Ollama работает на общем сервере, согласуй остановку задач с его владельцем.
1. Запиши, где появляется ошибка
Сохрани точный текст сообщения, время, название клиента и модель. Уточни: ошибка возникает при скачивании модели или уже при генерации? Загрузка файлов из интернета — отдельный этап; её проблемы разбираются в руководстве по ollama pull.
Для ошибки генерации составь карточку:
| Поле | Что записать |
|---|---|
| Клиент | Терминал, n8n, веб-интерфейс или собственный запрос |
| Модель | Полное имя с тегом из ollama list |
| Вход | Размер текста и число файлов |
| Время | До первой ошибки или первого фрагмента ответа |
| Нагрузка | Есть ли другие одновременные запросы |
Не публикуй в диагностике ключи, клиентские данные и полный рабочий документ. Для воспроизведения ниже достаточно учебной фразы.
2. Проверь прямой короткий запрос
Открой терминал на том компьютере, где работает Ollama, и выполни ollama list. Если список доступен, выбери уже загруженную небольшую модель. Запусти её через ollama run с её точным именем. Например, команда ниже подходит, только если gemma3:1b уже есть в списке; иначе запуск может сначала начать скачивание:
ollama run gemma3:1bОтправь учебный запрос:
Сократи до одного предложения без новых фактов:
Пилот поиска длится две недели. Участвуют 12 сотрудников.
Метрика успеха ещё не согласована.
Проверь, пришёл ли ответ и сохранил ли он все три факта. Повтори запрос в той же сессии. Первый запуск может включать загрузку модели в память, поэтому сравнивай первый и повторный отдельно. Для выхода используй /bye.
Если прямой запрос отвечает, а автоматизация обрывается, исследуй её адрес сервера, ограничения ожидания и способ чтения ответа. Увеличение таймаута клиента имеет смысл после измерения длительности, а не вместо выяснения причины.
3. Сверь нагрузку и журналы
Во втором окне терминала выполни ollama ps. По FAQ Ollama, команда показывает загруженные модели, а поле Processor помогает увидеть использование CPU и GPU. Работа на CPU сама по себе не ошибка; она может объяснять другую скорость по сравнению с ожидаемой.
Для просмотра журнала выбери свой вариант из официальной инструкции:
macOS: ~/.ollama/logs/server.log
Windows: %LOCALAPPDATA%\Ollama\server.log
Linux с systemd: journalctl -u ollama --no-pager
Ищи записи в момент конкретного запроса: загрузка модели, нехватка памяти, сбой GPU, отмена или ошибка соединения. Не считай любую старую ошибку причиной сегодняшнего сбоя. Сопоставь время клиента и сервера, учитывая часовой пояс.
Для личного пилота останови другие свои генерации и повтори один короткий запрос. Затем верни исходный длинный текст. Если маленький проходит, а большой нет, уменьшай объём входа или размер модели по одному параметру. Так будет понятно, какое изменение помогло.
4. Отдели три разных результата
| Наблюдение | Что проверять дальше |
|---|---|
| Даже короткий прямой запрос не отвечает | Запуск сервера, загрузку модели, память и журнал |
| Прямой запрос отвечает, клиент обрывает | Таймаут клиента, адрес, прокси и обработку ответа |
| Один запрос проходит, несколько — нет | Параллельную нагрузку и очередь |
Для API важно различать потоковый и непотоковый ответ. В непотоковом режиме клиент ждёт готовый результат целиком; потоковый режим требует корректно читать поступающие фрагменты. Сам по себе выбор streaming не исправляет нехватку памяти и не гарантирует отсутствие ограничений ожидания. Пример запроса есть в руководстве по API Ollama.
Не выставляй бесконечное ожидание и большое число повторов наугад. Автоматические повторы могут создать новые запросы, пока прежний ещё выполняется. Для теста оставь один запрос и запиши, чем он завершился.
Моя рекомендация: прежде чем менять настройки сервера, получить воспроизводимый маленький пример. С ним проще обсуждать проблему и проверять исправление.
Критерий завершения диагностики
Сбой можно считать локализованным, когда один и тот же учебный запрос проходит напрямую и через нужный клиент, а длительность укладывается в согласованное ожидание. После этого проверь реальный объём текста и предполагаемую нагрузку. Если ответа всё ещё нет, передай владельцу системы карточку запроса и обезличенный фрагмент журнала.
Для выбора более лёгкой модели используй наш разбор моделей Ollama. Построение проверяемых автоматизаций разбираем на курсе по агентам.
Команды и расположение журналов сверены с документацией. Таймаут на реальной машине не воспроизводился, замеры скорости не проводились.
Собери своего ИИ-агента и проверь результат
«AI Agents: от vibe coding к AI-команде»: desktop agents, MCP, skills, evals и harness. Отдельные воркшопы — от подключения инструментов до контроля качества.
7 практических воркшопов · записи · вопросы автору в чате
Посмотреть программу курса ↗