Как установить Ollama и запустить первую локальную модель
Установка Ollama на Windows, macOS и Linux, загрузка небольшой модели и проверка первого ответа через терминал.
Ollama позволяет запускать языковые модели на своём компьютере. Начнём с небольшой модели и одного короткого запроса: так проще проверить установку, не тратя время на загрузку десятков гигабайт.
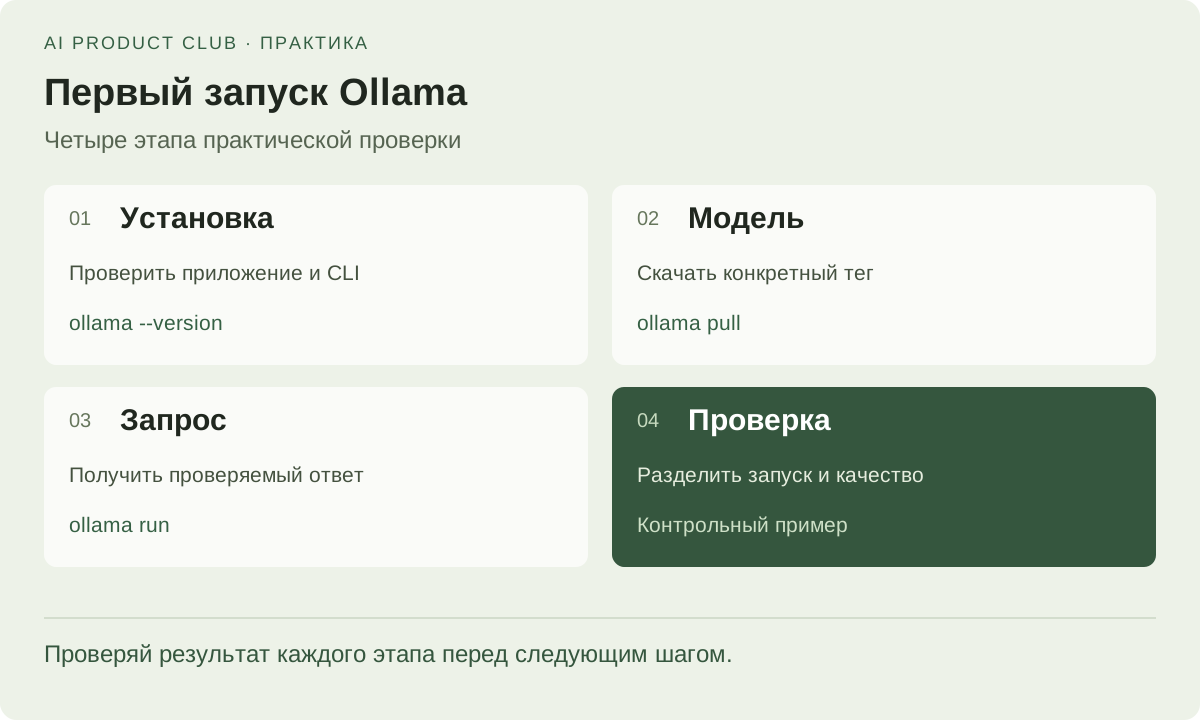
Мой подход. Я бы начинал с маленькой модели и вопроса с известным ответом. Сначала нужно убедиться, что вся цепочка работает, а уже потом сравнивать качество и скорость более тяжёлых моделей.
1. Установи приложение для своей системы
Скачай установщик с официального сайта Ollama. Для Windows используй нативное приложение, для macOS — приложение для Mac. После установки открой Ollama, затем новое окно терминала. На Windows подойдёт PowerShell. Системные требования проверяй на страницах Windows и macOS: версия ОС и поддержка ускорения важны ещё до выбора модели.
На Linux официальный способ установки использует скрипт. Его можно сначала скачать и прочитать, а затем запустить:
curl -fsSL https://ollama.com/install.sh -o ollama-install.sh
less ollama-install.sh
sh ollama-install.sh
Для выхода из less нажми q. Запуск скрипта устанавливает программное обеспечение и может запросить системные права. Альтернативные способы и настройка службы приведены в инструкции для Linux. Не запускай одновременно несколько копий сервера, если приложение или служба уже работают.
2. Проверь CLI и загрузи маленькую модель
В новом терминале выполни:
ollama --version
ollama pull qwen3:0.6b
ollama ls
Первая команда проверяет наличие CLI. Вторая скачивает модель, третья показывает локально доступные модели. Для учебного запуска используем конкретный тег qwen3:0.6b: он есть в каталоге Ollama, а размер скачивания на момент проверки составляет около 523 МБ. Это удобный тест установки, а не рекомендация выбирать эту модель для всех рабочих задач.
Размер файла не равен объёму памяти во время работы. Кроме весов, память занимает контекст и служебные данные. Если на компьютере мало свободной памяти, закрой тяжёлые приложения и начни с короткого запроса. Более крупную модель выбирай уже после успешного первого запуска.
Если загрузка прервалась, повтори pull для того же тега. Не меняй одновременно модель, сетевые настройки и способ установки: сначала прочитай конкретное сообщение об ошибке.
3. Отправь запрос с известным ответом
Запусти интерактивный диалог:
ollama run qwen3:0.6bОтправь такой текст:
Извлеки только название города из фразы:
«Встреча пройдёт в Казани в четверг».
Ответь одним словом, не добавляй дату и пояснения.
Ожидаемый смысловой результат — Казань. Форма слова может отличаться, поэтому заранее реши, нужна ли нормализация. Для этого примера считаем правильным название в именительном падеже. Если модель выводит дополнительные рассуждения, это отдельное наблюдение о формате, а не сбой установки.
Повтори проверку с фразой «Место встречи пока не выбрано» и просьбой отвечать «не указан», когда города нет. Этот второй случай показывает, умеет ли модель оставлять неизвестное неизвестным. Один удачный ответ не подтверждает качество на всей рабочей задаче.
В отдельном терминале выполни ollama ps, чтобы посмотреть запущенные модели. CLI также предоставляет ollama stop qwen3:0.6b для выгрузки модели. Команды описаны в справке Ollama CLI.
4. Разбери ошибку на нужном этапе
| Симптом | Что проверить |
|---|---|
| Команда не найдена | Установку CLI и новое окно терминала после установки |
| Не удаётся подключиться к серверу | Запущено ли приложение или служба Ollama |
| Модель не найдена | Точное написание тега и список ollama ls |
| Не хватает памяти | Размер модели, свободную память и длину контекста |
| Ответ медленный | Первую загрузку модели, используемый процессор и другие приложения |
| Ответ неверный | Текст задачи и качество модели на контрольных примерах |
Для ручного запуска сервера существует ollama serve. Он нужен, когда сервер ещё не работает; ошибка занятого порта при второй копии не требует переустановки всего приложения. После исправления повтори исходный запрос, а не только команду версии.
Сохрани тег модели, пример входа и полученный ответ. Это начальная точка для выбора модели под свой компьютер. Когда терминальный сценарий работает, переходи к Ollama API или подключению к n8n. Для локального запуска выбери именно локальный тег; наличие приложения Ollama само по себе не означает, что любой выбранный сервис работает без облака.
Преврати ИИ-инструменты в рабочую систему
«Быстрый старт в AI»: практические воркшопы по AI-инструментам, прототипам и автоматизации. Собираем результат, который можно применить в работе.
21 практических воркшопов · записи · вопросы автору в чате
Посмотреть программу курса ↗