Embeddings в Ollama: первый поиск по смыслу
Как получить embeddings через API Ollama и проверить поиск по трём учебным документам. Готовый Python-пример и критерии проверки.
Пользователь пишет «не могу попасть в аккаунт», а справка называется «восстановление пароля». Поиск только по совпадающим словам может пропустить нужный документ. Embeddings помогают сравнивать тексты по смысловой близости: модель превращает каждый текст в набор чисел, а поиск сопоставляет эти наборы.
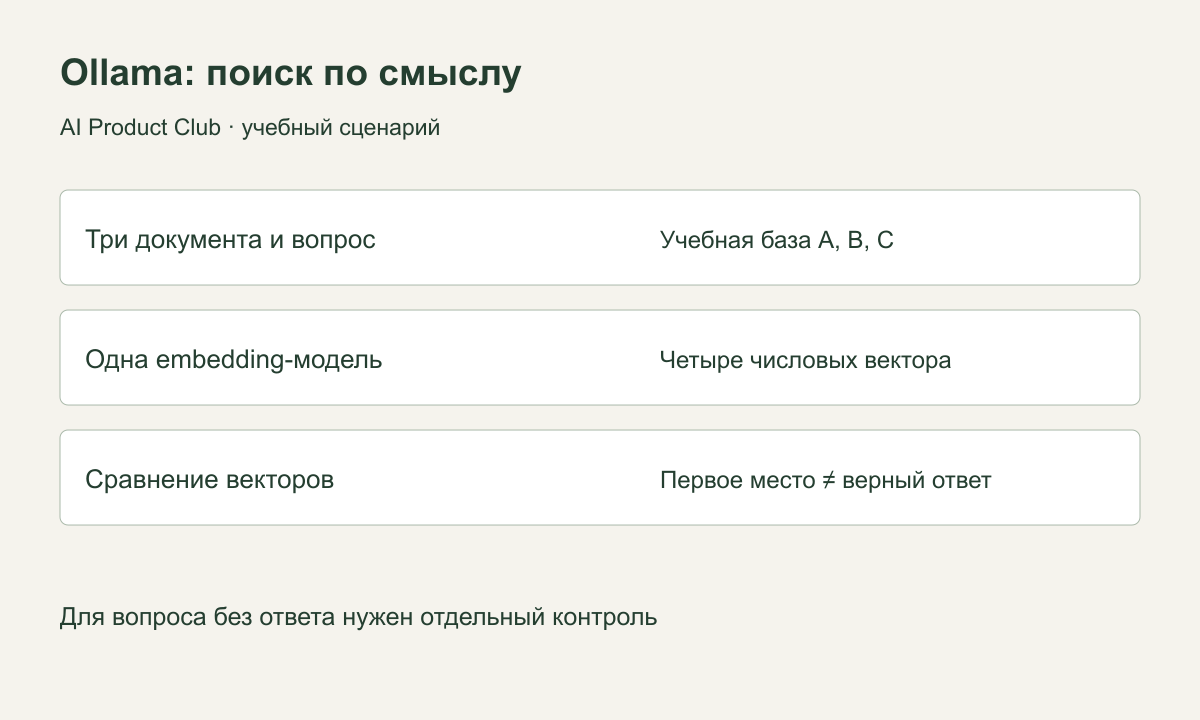
В этом упражнении получим векторы трёх учебных заметок через Ollama и отсортируем их для одного вопроса. База данных и чат-бот пока не нужны. Терминал потребуется для запроса к локальному API; готовый файл избавляет от написания программы с нуля.
1. Подготовь Ollama и модель
Если Ollama ещё нет, начни с инструкции установки. Запусти приложение или локальный сервис. В терминале выполни:
ollama pull embeddinggemmaКоманда скачивает embedding-модель. Она предназначена для представления текста числами; ждать от неё обычного разговорного ответа не нужно. В актуальной документации Ollama эта модель используется в примерах embeddings. Там же рекомендуется применять одну модель при обработке документов и поисковых запросов.
Работающая обычная чат-модель не доказывает, что нужная embedding-модель уже установлена. Проверь список командой ollama list. Размер загрузки и требования к памяти зависят от модели; не подменяй её произвольной моделью для чата.
2. Получи первый вектор через API
В macOS, Linux или WSL скопируй команду:
curl --fail-with-body http://127.0.0.1:11434/api/embed \
  -H 'Content-Type: application/json' \
  -d '{"model":"embeddinggemma","input":"Как восстановить пароль?","truncate":false}'
Для этого локального адреса не нужен облачный API-ключ. Подробнее о границах локального подключения — в руководстве Ollama API.
В ответе ищи поле embeddings: для одной строки это массив с одним числовым вектором внутри. Это не список найденных документов и не готовый ответ пользователю. Описание endpoint /api/embed принимает текст или массив текстов; параметр truncate: false позволяет получить ошибку при превышении контекста вместо тихого обрезания конца.
Если соединение отклонено, сначала проверь, запущен ли Ollama. Если не найдена модель, повтори проверку ollama list и имени в запросе. Ответ HTTP с ошибкой нельзя интерпретировать как пустой, но успешный результат поиска.
3. Сравни три учебных документа
Используем специально маленькую базу, чтобы правильный документ можно было выбрать вручную:
| ID | Учебный текст |
|---|---|
| A | Пароль можно восстановить через ссылку на странице входа. |
| B | Счёт за подписку находится в разделе Оплата. |
| C | Пригласить коллегу можно в настройках команды. |
Вопрос: «Не помню пароль, как снова войти?» Редакционный ориентир — документ A. Это ожидаемая релевантность по содержанию, а не обещание результата конкретной модели.
Скачай готовый Python-файл. В папке с ним выполни:
python3 ollama-embeddings-search.pyНужен Python 3; дополнительных Python-библиотек файл не устанавливает. Он отправляет четыре строки одним запросом: три документа и вопрос. Затем сравнивает каждый документ с вопросом и печатает три строки в порядке близости. В Windows при установленном Python можно использовать py вместо python3.
Для сравнения используется косинусная близость — мера направления двух векторов. Число рядом с документом не является вероятностью правильного ответа. Например, значение 0,8 не означает «точность 80%». Важны порядок документов и проверка на примерах твоего продукта, а не красивое число само по себе.
4. Проверь качество, а не только HTTP 200
Сначала убедись, что вернулось четыре непустых вектора одинаковой длины. Скрипт проверяет количество, размерности и допустимость чисел. Затем оцени первое место в выдаче.
Замени значение QUERY в файле и повтори запуск:
- «Где скачать счёт?» — ожидается B.
- «Как добавить сотрудника?» — ожидается C.
- «Можно ли получить возврат?» — подходящего документа в этой базе нет.
Третий вопрос особенно важен: сортировка всё равно поставит что-то первым. Первое место не доказывает наличие ответа. В реальном продукте понадобится правило отказа или дополнительная проверка достаточности найденного текста. Универсальный порог близости из чужого примера переносить нельзя: его выбирают на размеченных запросах своей базы.
Если A не оказался первым для вопроса о пароле, сохрани запрос, версию Ollama и имя модели. Проверь язык, формулировки, длину текстов; попробуй другие примеры. Не исправляй оценку вручную, чтобы демонстрация выглядела успешной.
5. Отдели поиск от генерации ответа
Полученные документы можно передать разговорной модели вместе с вопросом. Это следующий этап: сначала найти материал, затем составить ответ с опорой на него. При смене embedding-модели заново обработай документы и вопросы: векторы разных моделей нельзя считать совместимыми только из-за одинаковой длины.
Следующий шаг показан в сценарии RAG с n8n, а постановку задач для таких систем разбираем на курсе по ИИ-агентам. Документация проверена 13 ноября 2026 года. Код подготовлен редакцией; реальный запрос к модели и качество ранжирования для этой статьи не проверялись.
Собери своего ИИ-агента и проверь результат
«AI Agents: от vibe coding к AI-команде»: desktop agents, MCP, skills, evals и harness. Отдельные воркшопы — от подключения инструментов до контроля качества.
7 практических воркшопов · записи · вопросы автору в чате
Посмотреть программу курса ↗